lunes, 13 de noviembre de 2023

17.1.- Crear etiquetas y filtros de plantilla personalizados.

Crear etiquetas y filtros de plantilla personalizados.

Django nos ofrece una gran variedad de etiquetas de plantillas, tales como {% if  %} or {% block %}. Las hemos usado a lo largo de todos los capítulos anteriores. Puedes encontrar una referencia completa de las etiquetas de plantillas en https://docs.djangoproject.com/en/4.2/ref/templates/builtins/.

Pero Django también nos permite personalizar estas etiquetas de plantillas a nuestra necesidad. Es muy útil cuando necesitamos una funcionalidad que no esté contemplada por las etiquetas de Django. Siguiendo con nuestro proyecto podríamos crear una etiqueta para mostrar la lista de los últimos post que hayan sido publicados en el blog. Podríamos ponerla en un lateral de la página de forma que siempre este visible.

Creando etiquetas de plantilla personalizadas.

Django nos proporciona las siguientes funciones auxiliares que nos permiten crear fácilmente etiquetas personalizadas. 

  • simple_tag: Procesa los datos que la facilitemos y devuelve un string.
  • inclusion_tag: Procesa los datos que le facilitemos y devuelve una plantilla renderizada.
Las etiquetas de plantillas que creemos tienen que estar dentro de una aplicación de Django.

Dentro del directorio de la aplicación Blog vamos a crear un nuevo directorio llamado templatetags y dentro de el crearemos un archivo __init__.py. Crearemos tambien otro archivo llamado blog_tags.py. La estructura del directorio del que hemos hablado tiene que tener esta forma:

blog/
    __init__.py
    models.py
    ...
    templatetags/
        __init__.py
        blog_tags.py

La forma de llamar al archivo es importante. Utilizaremos el nombre del módulo para cargar nuestras etiquetas en las plantillas.

Implementando una etiqueta de plantilla "simple".

Vamos a empezar creando una etiqueta sencilla que nos devuelva el número total de post publicados en el blog.

Edita el archivo templatetags/blog_tags.py que acabamos de crear y añade el siguiente código.

PracticaDjango/Blog/templatetags/blog_tags.py

from django import template
from ..models import Post

register = template.Library()

@register.simple_tag
def posts_totales():
    return Post.objects.count()

Hemos creado nuestra primera etiqueta que devuelve el numero total de post. 

Cada módulo que contenga etiquetas de plantilla necesita definir una variable llamada register para que sea una etiqueta válida de la librería de Django. Esta variable es una instancia de template.Library(), y se usará para registrar todas las etiquetas y filtros de la aplicación.

En el código que acabamos de escribir, hemos definido una etiqueta llamada posts_totales a través de una simple función de Python. Hemos añadido el decorador @register.simple_tag a la función para registrarla como una etiqueta. Djando usará el nombre de la función como nombre de la etiqueta. Si quieres registrarla usando un nombre diferente, entonces debes especificar el nuevo nombre en un atributo de esta forma: @register.simple_tag(name='mi_etiqueta').

Nota: siempre después de crear nuevas etiquetas o filtros hay que reiniciar el servidor de desarrollo de Django para que se tomen los cambios.

Antes de usar las etiquetas debemos hacerlas disponibles para las plantillas usando al principio de la plantilla la etiqueta {% load %}. Como dijimos anteriormente necesitamos usar el nombre del módulo de Python que contiene la etiqueta que hemos creado.

Vamos a modificar la plantilla que renderiza la lista de post publicados, para que en la parte de la derecha flotando se muestre el número total de post publicados.

Edita el archivo Blog/lista.html de la aplicación Blog y añade la etiqueta {% load blog_tags %} para cargar nuestras etiquetas personalizadas, después de la etiqueta {% extends %} que debe ser la primera en aparecer. Después usa la etiquetas posts_totales para que se muestre el número total de post publicados. Debe quedar un código similar a este:

PracticaDjango/Blog/templates/Blog/lista.html

<!--Cargamos la plantilla base-->
{% extends "Proyecto_web_app/base.html" %}

<!-- Cargamos las etiquetas personalizada -->
{% load blog_tags %}

<!-- Establecemos el titulo de la página -->
{% block title %}Blog{% endblock %}

{% block content %}

<div class="container-fluid bg-white" style="margin-bottom: 50px;">

    <h1 class="text-center">Listado de Post publicados</h1>

    <div id="sidebar">
    <h2>El Blog</h2>
    <p>
        Hay escritos {% posts_totales %} posts hasta el momento.
    </p>
    </div>

    {% for post in posts %}
    ...

Vamos a añadir un poco de código de CSS para que el cajón se muestre en gris flotando en la parte superior derecha de la pantalla. Abre el archivo style.css y añade al final el siguiente código:

PracticaDjango/Proyecto_web_app/static/Proyecto_web_app/css/style.css

...
#sidebar { 
    float:right;
    width:30%;
    padding:10px;
    background:#efefef; 
    height:100%;
}
Necesitaras parar el servidor de desarrollo para que los cambios tengan efecto. Así que si lo tenias encendido pulsa CTrl + C y ejecútalo de nuevo usando el siguiente comando:

python manage.py runserver

Abre en tu navegador la dirección http://127.0.0.1:8000/blog/ y deberías ver el número total de post publicados como se puede ver en la siguiente imagen:

el numero total de post incluidos en la barra lateral


Implementando una etiqueta de plantilla "inclusion".


Vamos a crear otra etiqueta para mostrar los últimos post que se han publicado en el blog. Esta vez utilizaremos una etiqueta de plantilla "inclusion". Usando este tipo de etiquetas podemos devolver al usarla una plantilla con sus variables de contexto incluidas.

Edita el archivo templatetags/blog_tags.py y añade el siguiente código:

PracticaDjango/Blog/templatetags/blog_tags.py

#...
@register.inclusion_tag("Blog/ultimos_posts.html")
def mostrar_ultimos_posts(contador=5):
    ultimos_posts = Post.objects.order_by('-created')[:contador]
    return {'ultimos_posts': ultimos_posts}

En este código hemos registrado una nueva etiqueta usando el decorador @register.inclusion_tag. Hemos especificado la plantilla que será renderizada junto con las variables de contexto usando la plantilla "Blog/ultimos_posts.html". La plantilla de la etiqueta admitirá opcionalmente un parámetro llamado "contador" cuyo valor de defecto está establecido en 5. Este parámetro nos permitirá especificar el número de posts que queramos mostrar. Usaremos este párametro para limitar el número de valores obtenidos en la consulta Post.objects.order_by('-created')[:contador] al número que especifiquemos en el contador. 

Date cuenta de que la función devuelve un diccionario de variables en lugar de un único valor. La etiqueta creada con "inclusion" devuelve un diccionario de valores, las cuales se usan como contexto para renderizar la plantilla especificada. La etiqueta que hemos creado nos permite limitar el número de elementos que se mostrarán. Por ejemplo, si queremos mostrar 3 elementos usaremos {% mostrar_ultimos_posts 3 %}.

Ahora crearemos la plantilla que renderizará la etiqueta. Para ello crea una archivo dentro del directorio 'templates' de la aplicación Blog llamado ultimos_posts.html.

PracticaDjango/Blog/templates/Blog/ultimos_posts.html

<ul>
    {% for post in ultimos_posts %}
    <li>
        <a href="{{ post.get_absolute_url }}">{{ post.titulo }}</a>
    </li>
    {% endfor %}
</ul>
Con el código superior, se muestra una lista desordenada de post usando la variable ultimos_posts, devuelta por la etiqueta que creamos. Ahora edita el archivo lista.html de este mismo directorio y añadiremos la etiqueta que hemos creado para que se muestren los 3 últimos posts creados.


<!--Cargamos la plantilla base-->
{% extends "Proyecto_web_app/base.html" %}

<!-- Cargamos la etiqueta personalizada -->
{% load blog_tags %}

<!-- Establecemos el titulo de la página -->
{% block title %}Blog{% endblock %}

{% block content %}

<div class="container-fluid bg-white" style="margin-bottom: 50px;">

    <h1 class="text-center">Listado de Post publicados</h1>
    <div id="sidebar">
    <h2>El Blog</h2>
    <p>
        Hay escritos {% posts_totales %} posts hasta el momento.
    </p>
    <h3>Últimos Posts</h3>
    {% mostrar_ultimos_posts 3 %}
</div>

    {% for post in posts %}
    <h2>
        <a href="{{ post.get_absolute_url }}">{{post.titulo}}</a>
    </h2>
    <p class="date">Publicado {{ post.autor }} por {{ post.updated }} </p>
    {{ post.contenido|truncatewords:30|linebreaks }}
    {% endfor %}
</div>

<!-- {% include "Proyecto_web_app/paginacion.html" with page=posts %} -->
{% include "Proyecto_web_app/paginacion.html" with page=page_obj %}

<section>
    <div style="width: 75%; margin: auto; color: white; text-align: center;">
        Categorías:
        {% for categoria in categorias %}
        <a href="{% url 'Blog:categoria' categoria.id %}" class="link-info">
            <span style="color:rgb(2, 7, 59)">{{ categoria.nombre }}</span>
        </a>&nbsp;&nbsp;&nbsp;
        {% endfor %}
    </div>
</section>

{% endblock %}
Se llama a la etiqueta de la plantilla, pasándole el numero de posts a mostrar y la plantilla se renderiza en el lugar que la hayamos colocado con el contexto dado.

Ahora volvamos al navegador y recarguemos las página. La barra lateral debería tener un aspecto parecido a esto:


Creando una etiqueta de plantilla que devuelva un conjunto de consultas.

Finalmente crearemos una etiqueta "simple" que devuelva un valor. Guardaremos el resultado en una variable que podamos reutilizar, en vez de mostrarla directamente. Crearemos una etiqueta para mostrar el post más comentado.

Edita el archivo templatetags/blog_tags.py y  añade la siguiente importación y esta etiqueta de plantilla al mismo.

PracticaDjango/Blog/templatetags/blog_tags.py

@register.simple_tag
def obtener_posts_mas_comentados(contador=5):
    return Post.objects.annotate(comentarios_totales=Count("comentarios")).order_by(
        "-comentarios_totales"
    )[:contador]
En el código superior, hemos creado un conjunto de consultas o "queryset" que nos va a devolver un objeto con todos los posts que existen, lo hemos hecho con "Post.objects". A continuación agregamos una anotación al conjunto de resultados. En este caso, cuenta el número total de comentarios para cada post (.annotate(comentarios_totales=Count("comentarios") y lo guarda en un campo llamado "comentarios_totales". Para contar utilizamos la función "Count" de Django. Ten en cuenta que definimos "comentarios" al definir el modelo en models.py como un related_name lo cual nos da todos los comentarios de un determinado post. Finalmente ordenamos los resultados por orden descendente basandonos en los comentarios totales, de mas a menos comentarios.

Además de Count, Django nos ofrece las funciones para agregar objetos, Avg, Max, Min y Sum. Puedes encontrar más información sobre estas funciones en https://docs.djangoproject.com/en/4.2/topics/db/aggregation/.

Ahora edita la plantilla Blog/lista.html y añade el codigo resaltado en amarillo:


<!--Cargamos la plantilla base-->
{% extends "Proyecto_web_app/base.html" %}

<!-- Cargamos la etiqueta personalizada -->
{% load blog_tags %}

<!-- Establecemos el titulo de la página -->
{% block title %}Blog{% endblock %}

{% block content %}

<div class="container-fluid bg-white" style="margin-bottom: 50px;">

    <h1 class="text-center">Listado de Post publicados</h1>
    <div id="sidebar">
        <h2>El Blog</h2>
        <p>
            Hay escritos {% posts_totales %} posts hasta el momento.
        </p>
        <h3>Últimos Posts</h3>
        {% mostrar_ultimos_posts 3 %}
        <h3>Post más comentados</h3>
        {% obtener_posts_mas_comentados as posts_mas_comentados %}
        <ul>
            {% for post in posts_mas_comentados %}
            <li>
                <a href="{{ post.get_absolute_url }}">{{ post.titulo }}</a>
            </li>
            {% endfor %}
        </ul>
    </div>

    {% for post in posts %}
    <h2>
        <a href="{{ post.get_absolute_url }}">{{post.titulo}}</a>
    </h2>
    <p class="date">Publicado {{ post.autor }} por {{ post.updated }} </p>
    {{ post.contenido|truncatewords:30|linebreaks }}
    {% endfor %}
</div>

<!-- {% include "Proyecto_web_app/paginacion.html" with page=posts %} -->
{% include "Proyecto_web_app/paginacion.html" with page=page_obj %}

<section>
    <div style="width: 75%; margin: auto; color: white; text-align: center;">
        Categorías:
        {% for categoria in categorias %}
        <a href="{% url 'Blog:categoria' categoria.id %}" class="link-info">
            <span style="color:rgb(2, 7, 59)">{{ categoria.nombre }}</span>
        </a>&nbsp;&nbsp;&nbsp;
        {% endfor %}
    </div>
</section>

{% endblock %}
En el código anterior, almacenamos el resultado que proporciona la etiqueta que hemos creado en una variable personalizada ("obtener_posts_mas_comentados") usando el argumento "as" seguido del nombre de la variable ('posts_mas_comentados"). Luego usamos para una lista desordenada para devolver los resultados. 

Ahora vuelve a abrir el navegador y refresca la página para ver el resultado final que debería parecerse a este.

la plantilla lista.html, incluida la barra lateral que muestra los posts más comentados


Ahora que tienes una mayor idea de como construir plantillas personalizadas puedes encontrar más información en https://docs.djangoproject.com/en/4.2/howto/custom-template-tags/.

Implementando filtros personalizados.


Django viene con una gran variedad de filtros de plantilla integrados que nos permiten modificar las variables de las plantillas. Al final estas son funciones de Python que toman uno o dos parámetros, el valor de la variable a la que se aplica el filtro, y un argumento opcional. Devuelven un valor que puede ser mostrado o tratado por otro filtro.

Un filtro se puede escribir en una plantilla como {{ variable|mi_filtro }}. Los filtros en los que se pasa un argumento apareceran en las plantillas de esta forma {{variable|mi_filtro:"foo" }}. Por ejemplo, puedes usar el filtro 'capfirst', para poner en mayúsculas el primer carácter de una expresión, escribiendo {{ variable|capfirst }}. También puedes aplicar cuantos filtros quieras a una variable de la siguiente manera {{ variable|filtro1|filtro2|filtroN }} y cada filtro se aplicará sobre la salida del filtro anterior.

Puedes encontrar la lista completa de filtros de plantilla integrados en https://docs.djangoproject.com/en/4.2/ref/templates/builtins/#built-in-filter-reference.

Creando un filtro de plantilla para utilizar el método de Escritura MARKDOWN

Vamos a ver como crear un filtro personalizado que nos permita usar MARKDOWN en las publicaciones de nuestro Blog y luego convertir el cuerpo del post en lenguaje HTML en las plantillas.

MARKDOWN es un método de escritura de texto plano que es muy sencilla de usar y está pensado para que luego pueda convertirse en lenguaje HTML. Aprender la sintexis de MARKDOWN es mucho más fácil que aprender HTML. Podemos aprender el uso básico de MARKDOWN en el siguiente enlace https://markdown.es/.

Lo primero que tenemos que hacer es instalar el módulo markdown  a través de pip usando el siguiente comando en el shell:

pip install markdown

Después edita el archivo templatetags/blog_tags.py e incluye el siguiente código:

PracticaDjango/Blog/templatetags/blog_tags.py

#...
# Para utilizar markdown en el cuerpo del post.
from django.utils.safestring import mark_safe
import markdown
#...
@register.filter(name='markdown')
def markdown_format(texto):
    return mark_safe(markdown.markdown(texto))

Registramos el filtro de la plantilla igual que registramos las etiquetas. Para prevenir un conflicto de nombres entre el nombre de la función y el nombre del filtro, hemos llamado a la función markdown_format y a el filtro 'markdown' usando el atributo name, para poder usarlo en las plantillas como {{ variable|markdown }}

Django no tiene en cuenta el código HTML generado por los filtros, se escapa de él. Los caracteres HTML se reemplazan con sus caracteres codificados en HTML. Por ejemplo, la etiqueta <p> se convierte en &lt;p&gt; (menos en símbolo, la letra p y más que en símbolo)

Usamos la función mark_safe proporcionada por Django para marcar el resultado como HTML seguro para ser renderizado. De forma predeterminada, Django no confía en ningún código HTML y lo escapará, tal como vimos anteriormente, antes de colocarlo. Las únicas excepciones son las variables que están marcadas como a salvo de escapes. Esto evita que Django genere código potencialmente peligroso y te permite crear excepciones para devolver código HTML seguro.

Edita el código de la plantilla detalle.htm de la aplicación Blog y añade el código sombreado en amarillo:

PracticaDjango/Blog/templates/Blog/detalle.html

{% extends "Proyecto_web_app/base.html" %}

{% load blog_tags %}

{% block title %}Detalle de un Post{% endblock %}

{% block content %}
<div class="container-fluid bg-white" style="margin-bottom: 150px;">
    <h1>{{ post.titulo }}</h1>

    <p class="date">Publicado {{ post.autor }} por {{ post.updated }} </p>

    {{ post.contenido|markdown }}    

    {% with comentarios.count as total_comentarios %}
    <h2>
        {{ total_comentarios }} comentario{{ total_comentarios|pluralize }}
    </h2>
    {% endwith %}

    {% for comentario in comentarios %}
    <div class="comment">
        <p class="info">
            Comentario {{ forloop.counter }} de {{ comentario.autor }} -
            {{ comentario.created }}
        </p>
        {{ comentario.cuerpo|linebreaks }}
    </div>

    {% empty %}
    <p>No hay comentarios aún.</p>

    {% endfor %}

    <!-- Contenedor para centrar el botón de regresar a la lista de posts -->
    <div class="d-flex justify-content-center align-items-center">
        <a href="{% url 'Blog:lista_post' %}" class="btn btn-primary">Regresar</a>
    </div>
    {% include "Blog/form_comentario.html" %}
</div>
{% endblock %}

Hemos remplazado el filtro "linebreaks" de la etiqueta {{post.contenido}} con el filtro markdown que hemos creado. Este filtro no solo transforma los saltos de línea en etiquetas <p>, sino que también transforma el formato markdown en HTML.

Edita el código de la plantilla lista.htm de la aplicación Blog y añade el código sombreado en amarillo:

PracticaDjango/Blog/templates/Blog/lista.html

<!--Cargamos la plantilla base-->
{% extends "Proyecto_web_app/base.html" %}

<!-- Cargamos la etiqueta personalizada -->
{% load blog_tags %}

<!-- Establecemos el titulo de la página -->
{% block title %}Blog{% endblock %}

{% block content %}

<div class="container-fluid bg-white" style="margin-bottom: 50px;">

    <h1 class="text-center">Listado de Post publicados</h1>
    <div id="sidebar">
        <h2>El Blog</h2>
        <p>
            Hay escritos {% posts_totales %} posts hasta el momento.
        </p>
        <h3>Últimos Posts</h3>
        {% mostrar_ultimos_posts 3 %}
        <h3>Post más comentados</h3>
        {% obtener_posts_mas_comentados as posts_mas_comentados %}
        <ul>
            {% for post in posts_mas_comentados %}
            <li>
                <a href="{{ post.get_absolute_url }}">{{ post.titulo }}</a>
            </li>
            {% endfor %}
        </ul>
    </div>

    {% for post in posts %}
    <h2>
        <a href="{{ post.get_absolute_url }}">{{post.titulo}}</a>
    </h2>
    <p class="date">Publicado {{ post.autor }} por {{ post.updated }} </p>
    <!-- {{ post.contenido|truncatewords:30|linebreaks }} -->
    {{ post.contenido|markdown|truncatewords_html:15}}
    {% endfor %}
</div>

<!-- {% include "Proyecto_web_app/paginacion.html" with page=posts %} -->
{% include "Proyecto_web_app/paginacion.html" with page=page_obj %}

<section>
    <div style="width: 75%; margin: auto; color: white; text-align: center;">
        Categorías:
        {% for categoria in categorias %}
        <a href="{% url 'Blog:categoria' categoria.id %}" class="link-info">
            <span style="color:rgb(2, 7, 59)">{{ categoria.nombre }}</span>
        </a>&nbsp;&nbsp;&nbsp;
        {% endfor %}
    </div>
</section>

{% endblock %}

Hemos realizado lo mismo que en el archivo anterior. Solamente hemos usado "truncate_html" en vez de "truncate" porque el código generado ya es html.

Ahora abre el navegador, ve a la consola de administración de Django y añade un nuevo post con el siguiente contenido:

Este es un post usando markdown
--------------------------------------

*Este texto esta en cursiva*  y **este en negrita**.

Aquí hay una lista:

- Uno
- Dos
- Tres

Y un  [link to the Django website](https://www.djangoproject.com/).
Una vez creado, ve de nuevo al navegador localiza el nuevo post y haz clic en el título para verlo en detalle. Su aspecto debería de ser algo como esto:

Post usando un filtro markdown


Como puedes ver los filtros de plantilla son muy útiles para personalizar el formato de una plantilla. puedes encontrar más información en https://docs.djangoproject.com/en/4.2/howto/custom-template-tags/#writing-custom-template-filters.


domingo, 29 de octubre de 2023

16.1 - Mejorando la aplicación BLOG con características avanzadas (URL canónicas, SEO, Paginación)

En el capítulo anterior, aprendimos los componentes principales de Django desarrollando un blog dentro de la aplicación principal. Creamos una aplicación de blog sencilla utilizando vistas, plantillas y URLs. En este capítulo,  ampliaremos las funcionalidades de la aplicación del blog con características nuevas.

Usando URLs canónicas para los modelos.


Un sitio web puede tener diferentes páginas que muestran el mismo contenido. Tal como nos dice Google "Si tienes una página a la que se puede acceder mediante varias URLs, o bien páginas diferentes con contenido similar (por ejemplo, una página para móviles y otra para ordenadores), Google las considerará versiones duplicadas de la misma página. En este caso, elegirá una URL como canónica, que es la que rastreará, y considerará que las otras URLs son duplicados, por lo que las rastreará con menos frecuencia". 

Django te permite implementar el método get_absolute_url() en los modelos para devolver la URL canónica del objeto.

Usaremos la URL detalle_post definida en los patrones de URL de la aplicación para construir la URL canónica para los post de la publicación. 

Django proporciona diferentes funciones de resolución de URL que le permiten construir
URL dinámicamente usando su nombre y cualquier parámetro requerido. Usaremos la utilidad reverse() del módulo django.urls.

Edita el archivo models.py de la aplicación de blog para importar la función reverse() y añade el método get_absolute_url() al modelo Post de la siguiente manera. El nuevo código está resaltado en negrita:

PracticaDjango/Blog/models.py: 

from django.db import models

from django.contrib.auth.models import User

# Para importar el usuario que esta creando el post

from django.utils import timezone

# Para importar el timezone y establecer la fecha de creación.

from django.urls import reverse

# Para crear la Url canónica


# Create your models here.
class Categoria(models.Model):
    """Diferentes tags para asignar a los post"""

    nombre = models.CharField(max_length=50)
    created = models.DateTimeField(default=timezone.now)
    updated = models.DateTimeField(auto_now=True)

    def __str__(self):
        return self.nombre


class Post(models.Model):
    titulo = models.CharField(max_length=250)
    slug = models.CharField(max_length=250)
    contenido = models.TextField()
    autor = models.ForeignKey(User, on_delete=models.CASCADE, related_name="blog_posts")
    categorias = models.ManyToManyField(Categoria, null=True, blank=True)
    created = models.DateTimeField(auto_now_add=True)
    updated = models.DateTimeField(auto_now=True)

    # Model meta Options - https://docs.djangoproject.com/en/4.1/topics/db/models/#meta-options
    class Meta:
        verbose_name = "post"
        verbose_name_plural = "posts"
        ordering = ['-updated']
        indexes = [
            models.Index(fields=['updated']),
        ]

    def __str__(self):
        return self.titulo
    
    def get_absolute_url(self):
        return reverse("Blog:detalle_post", args=[self.id])
La función reverse() construirá la URL de forma dinámica, usando el nombre URL definido en los patrones URL de la aplicación. Hemos usado el namespace 'Blog' seguido de dos puntos y el nombre de URL 'detalle_post'. Recuerda que el namespace 'Blog' esta definido en el archivo urls.py principal de la aplicación ya que hemos incluido el patrón de la URL en Blog.urls. La URL de 'detalle_post' está definido en el archivo urls.py de la aplicación Blog. El resultado 'Blog:detalle_post' puede usarse de forma global en todo el proyecto para referirnos a la URL de detalle_post. Esta Url tiene un parámetro requerido, que es el id del post. Lo hemos incluido como un argumento posicional a través de args=[self.id].

Puedes encontrar más información sobre utilidades para URLs de Django en el siguiente en https://docs.djangoproject.com/en/4.2/ref/urlresolvers/.

Reemplacemos la URLs de 'detalle_post' en la plantilla con el nuevo método get_absolute_url().

Edita el archivo de plantilla Blog/lista.html y remplaza la siguiente línea:

<a href="{% url 'Blog:detalle_post' post.id %}">{{post.titulo}}</a>
Con la línea:

<a href="{{ post.get_absolute_url }}">{{post.titulo}}</a>
La plantilla /Blog/lista.html debería tener un aspecto similar a este:

PracticaDjango/Blog/templates/Blog/lista.html

<!--Cargamos la plantilla base-->
{% extends "Proyecto_web_app/base.html" %}

<!-- Establecemos el titulo de la página -->
{% block title %}Blog{% endblock %}

{% block content %}
<div class="container-fluid bg-white" style="margin-bottom: 50px;">
    <h1 class="text-center">Listado de Post publicados</h1>
    {% for post in posts %}
        <h2>
            <a href="{{ post.get_absolute_url }}">{{post.titulo}}</a>
        </h2>
        <p class="date">Publicado {{ post.autor }} por {{ post.updated }} </p>
        {{ post.contenido|truncatewords:30|linebreaks }}
    {% endfor %}   
</div>
...

También para que funcionen los enlaces de los post que pertenecen a cada una de las categorías tenemos que modificar en el mismo sentido el archivo Blog/categoria.html

PracticaDjango/Blog/templates/Blog/categoria.html

{% block content %}
<div class="container-fluid bg-white" style="margin-bottom: 50px;">
    <h1 class="text-center">Listado de Post publicados por "{{categoria}}"</h1>
    {% for post in posts %}
    <h2>
        <a href="{{ post.get_absolute_url }}">{{post.titulo}}</a>
    </h2>
    <p class="date">Publicado {{ post.autor }} por {{ post.updated }} </p>
    {{ post.contenido|truncatewords:30|linebreaks }}
    {% endfor %}
</div>
<!-- Contenedor para centrar el botón de regresar a la lista de posts -->

Ahora abre el shell y ejecuta el servidor para ver que todo sigue funcionando correctamente.


Creando URL amigables para los SEO de las publicaciones.


La URL canónica para la vista detallada de una entrada de blog actualmente se ve como /blog/1/.
Cambiaremos el patrón de la URL para crear URLs que sean amigables para los SEO de los buscadores. Utilizaremos tanto la fecha de creación como los valores de la "slug" (una especie de resumen del título de la entrada) para construir las URL de las entradas individuales. Al combinar las fechas, haremos que la URL de una entrada en detalle se parezca a esto: /blog/2023/10/25/este-primer-post-prueba/. Proporcionaremos a los motores de búsqueda, URLs amigables para que las indexen y que contengan tanto el título como la fecha de la entrada.

Para recuperar post individuales mediante la combinación de la fecha de creación y la "slug" (una especie de resumen del título de la entrada), debemos asegurarnos de que ningún post se almacene en la base de datos con la misma "slug" y fecha de creación que uno existente. Para prevenir la duplicación de entradas en el modelo "Post", definiremos las "slugs" como únicas para la fecha de creación de la entrada.

Para lograrlo, debes editar el archivo "models.py" y agregar el parámetro "unique_for_date" al campo "slug" del modelo "Post".

PracticaDjango/Blog/models.py: 

...
class Post(models.Model):
   ...
    slug = models.CharField(max_length=250, unique_for_date='created')
   ...
Al utilizar "unique_for_date", se requiere que el campo "slug" sea único para la fecha de creación. Esto evita duplicados en las entradas para una misma fecha. Los cambios en el modelo no requieren una migración de la base de datos, pero crearemos una migración para mantener el seguimiento de cambios en el modelo. 

El comando a ejecutar en la consola es el habitual al realizar migraciones en el modelo.

$ python manage.py makemigrations Blog
$ python manage.py migrate

Modificando los patrones de las URLs.


Vamos a modificar los patrones de las URLs para que usen la fecha de creación y el slug para crear la dirección URL de la vista detalle_post.

Edita el archivo urls.py de la aplicación Blog y reemplaza la siguiente línea:

PracticaDjango/Blog/urls.py: 

path('<int:id>/', views.detalle_post, name='detalle_post'),
Con las siguientes líneas:

PracticaDjango/Blog/urls.py: 

path('<int:year>/<int:month>/<int:day>/<slug:post>/',
views.detalle_post,
name='detalle_post'),
Con esto el patrón de la vista para 'detalle_post' tendrá los parámetros 'year', 'month', 'date' que tendrán que ser números enteros y el parámetro 'post' que tendrá que ser de tipo slug, es decir una cadena de texto que solo tendrá caracteres en minúsculas y guiones.


Modificando las vistas.


Ahora tenemos que modificar los parámetros de la vista 'detalle_post' para que coincidan con los parámetros de la nueva URL y usarlos para recuperar el correspondiente objeto Post.

Edita el archivo views.py y modifica la vista detalle_post de la siguiente forma:

PracticaDjango/Blog/views.py

...
def detalle_post(request, year, month, day, post):
    """Muestra todos los post"""
    post = get_object_or_404(Post, 
                             slug=post,
                             created__year=year,
                             created__month=month,
                             created__day=day)
    return render(request, 'Blog/detalle.html', {'post': post})
...
Hemos modificado la vista detalle_post para tomar los argumentos de año, mes, día y created y recuperar un post con el slug y la fecha de creación indicados. Al agregar unique_for_date='created' a el campo slug del modelo de publicación anteriormente, nos aseguramos de que solo habrá un post con un slug para un fecha dada. Por lo tanto, podemos recuperar publicaciones individuales utilizando la fecha y el slug.


Modificar la URL canónica para las post.


Tenemos también que modificar los parámetros de la URL canónica para los post del blog para que coincidan con la nueva URL.

Editemos el archivo models,py de la aplicación Blog y editaremos el método get_absolute_url() de la siguiente forma:

PracticaDjango/Blog/models.py

class Post(models.Model):
...
def get_absolute_url(self):
        return reverse("Blog:detalle_post", 
                       args=[self.created.year,
                             self.created.month,
                             self.created.day,
                             self.slug])

Añadiendo Paginación para la lista de Post.


A medida que se vayan añadiendo post al contenido del blog, estos fácilmente pueden llegar a ser varios cientos. En vez de mostrarlos en una única página sería mejor dividirlos en varios post a lo largo de diversas páginas y diseñar una barra de navegación para poder ir entre ellas. A esto es lo que se llama paginación y puedes encontrarlo en casi cualquier aplicación que muestre una larga lista de elementos. 

Un ejemplo de esto es la paginación que muestra Google cuando muestra los resultados de una búsqueda.


Django ya tiene incorporada una clase que hace posible esto de forma sencilla. Solamente tenemos que definir el número de objetos que queremos que se muestren en cada página

Edita el archivo de vistas de la aplicación blog "views.py" y modifica la vista "detalle_post" de la siguiente manera:

PracticaDjango/Blog/views.py

from django.shortcuts import render, get_object_or_404, get_list_or_404

from .models import Post, Categoria

from django.core.paginator import Paginator

# Create your views here.


def lista_post(request):
    posts = get_list_or_404(Post)
    categorias = get_list_or_404(Categoria)
    # Paginación con 3 post por página.
    paginador = Paginator(posts, 3)
    numero_pagina = request.GET.get('page', 1)
    posts_por_pagina = paginador.page(numero_pagina)
    return render(
        request, "Blog/lista.html", {"posts": posts_por_pagina, "categorias": categorias}
    )

Vamos a echarle un vistazo al nuevo código que hemos añadido a la vista.

  1. Hemos instanciado la clase 'Paginator' pasándole como argumentos los post y el número de objetos a devolver por página.
  2. Hemos recuperado el número de la página a mostrar del GET del request. Como funciona como un diccionario le pedimos que recupere el número de página y si no existiera que nos devuelva 1, que será el valor por defecto que cargará la primera página de los resultados.
  3. Obtenemos los objetos para cada página llamando al método 'page' de paginacion. Este método devuelve un objeto que se guardara en la variable posts_por_pagina.
  4. Pasamos a la plantilla este objeto que contendrá el número de página y los post que han de mostrarse en ella.

Creando la plantilla para la paginación.


Necesitamos crear un sistema de navegación para que los usuarios puedan navegar a través de las diferentes páginas. Crearemos una plantilla para mostrar los enlaces a las páginas. Lo haremos genérico para que lo podamos usar siempre que lo necesitemos en nuestra web.

En el archivo de las plantillas generales de Proyecto_web_app, crea un nuevo archivo y llámalo paginacion.html. Añade el siguiente código HTML al archivo:

PracticaDjango/Proyecto_web_app/templates/Proyecto_web_app/paginacion.html

<div>
    <ul class="pagination">

        {% if page.has_previous %}
            <li class="page-item">
                <a class="page-link" href="?page={{ page.previous_page_number }}">
                    Anterior
                </a>
            </li>
        {% endif %}

        <li class="page-item">
            <a class="page-link" href="#">
               Página {{ page.number }} de {{ page.paginator.num_pages }}
            </a>
        </li>

        {% if page.has_next %}
            <li class="page-item">
                <a class="page-link" href="?page={{ page.next_page_number }}">
                    Siguiente
                </a>
            </li>
        {% endif %}
    </ul>
</div>

La plantilla espera tener el objeto Page en el contexto para renderizar el link posterior o anterior y mostrar la página actual y el número de páginas total.

Ahora volvamos a la plantilla Blog/lista.html y añade al final del bloque { % content % } lo siguiente:

PracticaDjango/Blog/templates/Blog/lista.html

<!--Cargamos la plantilla base-->
{% extends "Proyecto_web_app/base.html" %}

<!-- Establecemos el titulo de la página -->
{% block title %}Blog{% endblock %}

{% block content %}
<div class="container-fluid bg-white" style="margin-bottom: 50px;">
    <h1 class="text-center">Listado de Post publicados</h1>
    {% for post in posts %}
        <h2>
            <a href="{{ post.get_absolute_url }}">{{post.titulo}}</a>
        </h2>
        <p class="date">Publicado {{ post.autor }} por {{ post.updated }} </p>
        {{ post.contenido|truncatewords:30|linebreaks }}
    {% endfor %}   
</div>

{% include "Proyecto_web_app/paginacion.html" with page=posts %}

<section>
    <div style="width: 75%; margin: auto; color: white; text-align: center;">
        Categorías:
        {% for categoria in categorias %}
        <a href="{% url 'Blog:categoria' categoria.id %}" class="link-info">
            <span style="color:rgb(2, 7, 59)">{{ categoria.nombre }}</span>
        </a>&nbsp;&nbsp;&nbsp;
        {% endfor %}
    </div>
</section> 

{% endblock %}

La etiqueta {% include  %} carga la plantilla que hemos creado anteriormente y la renderiza pero usando el contexto de la etiqueta actual. Usamos "with" para pasarle variables adicionales de contexto a la plantilla. La plantilla de paginación utiliza la variable 'page' para renderizar, mientras que el objeto que pasamos desde nuestra vista a la plantilla se llama "posts". Utilizamos "with page=posts" para pasar la variable esperada por la plantilla de paginación. Puedes seguir este método para utilizar la plantilla de paginación con cualquier tipo de objeto.

Si ejecutas el servidor y vas a la página del blog, verás algo semejante a esto (procura tener más de 7 post):

paginacion


Manejando errores de paginación.


Ahora que la paginación funciona, podemos añadir algo para tratar con los errores que pueden surgir en la paginación de las vistas. El parámetro 'page' que hemos usado en la vista para recuperar la página solicitada podría potencialmente usarse con valores erróneos, como intentar ir a una página que no existe o pasar un string de texto en vez de un número de página. Vamos a implementar una captura de errores adecuada para evitar esto.

Abre el navegador e introduce como valor de página un número de página que no exista. En mi caso como tengo 7 post introducidos, solamente hay 3 páginas, por lo que si introduzco cualquier otro número dará un error. Abre el navegador e introduce la dirección http://127.0.0.1:8000/blog/?page=7. Deberías ver el siguiente mensaje de error:


Error de página EmptyPage


El objetor paginador lanza un mensaje de error "EmptyPage" porque estamos intentando acceder a una página que está fuera de rango. No hay resultados que mostrar. 

Edita el archivo views.py de la aplicación Blog importa el módulo 'EmptyPage' y modifica el código de la siguiente manera. 

PracticaDjango/Blog/views.py

from django.shortcuts import render, get_object_or_404, get_list_or_404

from .models import Post, Categoria

from django.core.paginator import Paginator, EmptyPage

# Create your views here.


def lista_post(request):
    posts = get_list_or_404(Post)
    categorias = get_list_or_404(Categoria)
    # Paginación con 3 post por página.
    paginador = Paginator(posts, 3)
    numero_pagina = request.GET.get('page', 1)
    try:
        posts_por_pagina = paginador.page(numero_pagina)
    except EmptyPage:
        # Si la página está fuera del rango de las paginas de resultados
        posts_por_pagina = paginador.page(paginador.num_pages)
    return render(
        request, "Blog/lista.html", {"posts": posts_por_pagina, "categorias": categorias}
    )
...

Con este código si la pagina solicitada esta fuera del rango, se mostrará la última página de los resultados. Conseguimos saber el numero total de paginas que tiene el paginador usando "paginador.num_pages". El numero total de páginas es igual que el último numero de página.

Pero a nuestra vista tambien le podemos pasar algo que sea diferente a un entero como parámetro de página. Por ejemplo abre el navegador y ve a http://127.0.0.1:8000/blog/?page=alapollo

Error de página PageNotAnInteger


En este caso el paginador nos lanza el error "PageNotAnInteger", de que el párametro introducido no es un número entero. Veamos como tratar este error. 

Edita el archivo views.py de la aplicación Blog importa el módulo 'PageNotAnInteger' y modifica el código de la siguiente manera:

PracticaDjango/Blog/views.py

from django.shortcuts import render, get_object_or_404, get_list_or_404

from .models import Post, Categoria

from django.core.paginator import Paginator, EmptyPage, PageNotAnInteger

# Create your views here.


def lista_post(request):
    posts = get_list_or_404(Post)
    categorias = get_list_or_404(Categoria)
    # Paginación con 3 post por página.
    paginador = Paginator(posts, 3)
    numero_pagina = request.GET.get('page', 1)
    try:
        posts_por_pagina = paginador.page(numero_pagina)
    except EmptyPage:
        # Si la página está fuera del rango de las paginas de resultados
        posts_por_pagina = paginador.page(paginador.num_pages)
    except PageNotAnInteger:
        # Si el párametro introducido no es un número entero
        posts_por_pagina = paginador.page(1)
    return render(
        request, "Blog/lista.html", {"posts": posts_por_pagina, "categorias": categorias}
    )
...

Con esto, si la página solicitada no es un número entero, se devolverá la primera página de los resultados.

Después de ver esto ya tenemos la paginación del blog plenamente implementada. Puedes encontrar más información en https://docs.djangoproject.com/en/4.2/ref/paginator/


Construir las vistas usando clases.


Hasta el momento hemos usado funciones para crear las vistas de la aplicación. Las vistas basadas en funciones son efectivas y muy sencillas de implementar. Sin embargo Django también permite usar clases para construir las vistas.

Como una vista es una función que toma una petición web y devuelve una respuesta web, puedes definir las vistas como métodos de una clase. Las vistas basadas en clases tienen algunas ventajas sobre las que se basan en funciones ya que son muy útiles en determinados casos:
  • Organizar el código relacionado con los métodos HTTP, como GET, POST o PUT, en métodos separados en lugar de utilizar ramificaciones condicionales.
  • Utilizar la herencia múltiple para crear clases de vista reutilizables (también conocidas como mezclas).


Usar una vista basada en clases para listar los Post.


Para entender como funcionan las vistas basadas en clases, vamos a crear una que es la equivalente a la que hasta ahora era la función que listaba los post del blog "lista_post". Crearemos una clase que heredará de una clase generica llamada ListView que nos facilita Django. ListView nos permite listar cualquier clase de objetos.

Edita el archivo views.py de la aplicación blog, comenta la funcion lista_post y añade el siguiente código:

PracticaDjango/Blog/views.py

from django.shortcuts import render, get_object_or_404, get_list_or_404

from .models import Post, Categoria

# from django.core.paginator import Paginator, EmptyPage, PageNotAnInteger

from django.views.generic import ListView

# Create your views here.

class lista_post(ListView):
    """
    Una alternativa a la función lista_post
    """
    model = Post
    context_object_name = 'posts'
    paginate_by = 3
    template_name = "Blog/lista.html"
...

La clase lista_post es análoga a la función que teníamos anteriormente pero con mucho menos código. Hemos implementado una vista basada en una clase que hereda de la clase ListView. La vista esta definida con los siguientes atributos:

  • model = 'Post' especifica que la vista trabajará con el modelo 'Post'. Podríamos haber utilizado una expresión análoga como queryset = Post.objects.all(), pero esta expresión es mucho más sencilla.
  • Usamos la variables de contexto 'posts' que es la que están utilizando las plantillas para mostar los resultados de la consulta. La variable que se usa por defecto es object_list si tu no especificas ningún context_object_name.
  • Especificamos la paginación con la propiedad paginate_by para decirle a Django que muestre tres objetos por página.
  • Usaremos la plantilla personalizada para renderizar la página usando template_name. Si no especificas ninguna plantilla por defecto Django buscará la plantilla en /Blog/lista_post.html, es decir dentro de template en /nombre_aplicacion/nombre_clase.html

Ahora, edita el archivo urls.py de la aplicación Blog, comenta el parámetro de la función lista_post que usábamos anteriormente y agrega el siguiente patrón URL para la clase lista_post que acabamos de crear:

PracticaDjango/Blog/urls.py

from django.urls import path
from . import views

app_name = 'Blog'

urlpatterns = [
# post views
# path('', views.lista_post, name='lista_post'),
path('', views.lista_post.as_view(), name='lista_post'),
path('<int:year>/<int:month>/<int:day>/<slug:post>/', views.detalle_post, name='detalle_post'),
path('categoria/<int:categoria_id>/', views.categoria, name='categoria'),
]
Como ves la única diferencia es añadir .as_view() cuando se trata de una vista definida mediante una clase.

Para mantener funcionando la paginación, debemos utilizar el objeto de página correcto que se pasa a la plantilla. La vista genérica ListView de Django pasa la página solicitada en una variable llamada 'page_obj'. Debemos editar la plantilla 'Blog/lista.html' en consecuencia, para incluir el paginador utilizando la variable correcta, de la siguiente manera:

PracticaDjango/Blog/templates/Blog/lista.html

    ...  
     <p class="date">Publicado {{ post.autor }} por {{ post.updated }} </p>
        {{ post.contenido|truncatewords:30|linebreaks }}
    {% endfor %}   
</div>

<!-- {% include "Proyecto_web_app/paginacion.html" with page=posts %} -->
{% include "Proyecto_web_app/paginacion.html" with page=page_obj %}

<section>
    <div style="width: 75%; margin: auto; color: white; text-align: center;">
        Categorías:
        {% for categoria in categorias %}
...

Para finalizar solo nos queda agregar las categorías de los post al contexto. Lamentablemente, no se pueden definir multiples modelos en la clase "ListView", ya que esta esta diseñada para trabajar con un solo modelo a la vez. 

Sin embargo podemos añadir más de un objeto al contexto utilizando el método "get_context_data". Edita el archivo views.py y añade el siguiente código:

PracticaDjango/Blog/views.py

from django.shortcuts import render, get_object_or_404, get_list_or_404

from .models import Post, Categoria

# from django.core.paginator import Paginator, EmptyPage, PageNotAnInteger

from django.views.generic import ListView

# Create your views here.

class lista_post(ListView):
    """
    Una alternativa a la función lista_post
    """
    model = Post
    context_object_name = 'posts'
    paginate_by = 3
    template_name = "Blog/lista.html"

    def get_context_data(self, **kwargs):
        context = super().get_context_data(**kwargs)
        context['categorias'] = Categoria.objects.all()
        return context
...

Lo primero que hacemos dentro de la clase es sobrescribir el método "get_context_data" para personalizar el contexto que se pasa a la plantilla. Este método se llama para obtener el contexto de la vista.

Luego llamamos al método "super().get_context_data(**Kwargs)" para obtener el contexto predeterminado y lo almacenamos en la variable "context".

Terminamos añadiendo context['categorias'] al contexto y lo llenamos con todos los objetos de la clase "Categoria" utilizando Categoria.objects.all(). Esto hace que la lista de categorías este disponible en la plantilla con el nombre de 'categorias'.


domingo, 17 de septiembre de 2023

Explorando el Funcionamiento de la Base de Datos SQLite3 en Python

Explorando el Funcionamiento de la Base de Datos SQLite3 en Python


En el mundo de la programación, el manejo de datos es una parte esencial de muchas aplicaciones. Ya sea que estemos creando una aplicación web, una aplicación de escritorio o incluso una aplicación móvil, es probable que necesitemos almacenar y recuperar información de manera eficiente. Una de las herramientas más populares para manejar bases de datos en Python es SQLite. En este artículo, exploraremos en detalle el funcionamiento de la base de datos SQLite en el entorno de programación de Python.


¿Qué es SQLite?


SQLite es una biblioteca escrita en lenguaje C que proporciona un sistema de gestión de bases de datos relacionales de código abierto y sin servidor. A diferencia de otras bases de datos más robustas, SQLite es una base de datos de un solo archivo, lo que significa que toda la base de datos y el motor de gestión están contenidos en un solo archivo. Esto lo hace extremadamente ligero y fácil de integrar en aplicaciones Python sin la necesidad de configuraciones complejas.


Ventajas de SQLite en Python:


1. Sin configuración compleja: SQLite no requiere configuraciones de servidor complicadas. La base de datos se maneja como un archivo local, lo que facilita su gestión y distribución junto con la aplicación.


2. Eficiencia: Aunque SQLite es una base de datos de un solo archivo, ofrece un rendimiento sorprendentemente rápido para muchas aplicaciones. Es ideal para proyectos más pequeños o aplicaciones que no requieren una escalabilidad extrema.


3. Compatibilidad: Python tiene una integración incorporada con SQLite, lo que significa que no es necesario instalar bibliotecas adicionales. La mayoría de las distribuciones de Python vienen con la biblioteca SQLite lista para usar.


4. Transacciones ACID: SQLite garantiza la integridad de los datos utilizando el concepto de transacciones ACID (Atomicidad, Consistencia, Aislamiento y Durabilidad), lo que garantiza que las operaciones sean seguras y confiables.


Trabajando con SQLite en Python:


Esquema de funcionamiento:

1.- Importar la biblioteca.
2.- Abrir o Crear la conexión.
3.- Crear un cursor o puntero.
4.- Ejecutar una consulta o query SQL.
5.- Manejar los resultados de la query o consulta. CRUD (create, read, update and delete)
6.- Cerrar la conexión y el puntero.

En una base de datos de este tipo los datos se guardan en tablas. Imaginemos que tenemos una pequeña biblioteca y queremos llevar un registro de los libros que tenemos. En este caso nuestra entidad, el libro, tiene un montón de atributos que queremos guardar. (Titulo, Año, Precio, Descripción). Pues bien nuestra tabla de libros tendrá una serie de filas y columnas. En las columnas estarán los atributos de cada libro y en las filas guardaremos cada registro, es decir los atributos de cada libro.


A continuación, se presentan los pasos básicos para trabajar con la base de datos SQLite en Python:


1. Importar la biblioteca: Comenzamos importando el módulo 'sqlite3', que proporciona las funciones y clases necesarias para interactuar con la base de datos. Como hemos dicho antes forma parte de la biblioteca estándar de Python por lo que no hay que instalar ningún módulo con con 'pip'.


import sqlite3


2. Conectar a la base de datos: Usamos la función 'connect()' para establecer una conexión con la base de datos o crear una nueva si no existe.


conexion = sqlite3.connect('mi_base.db')


La primera vez que ejecutemos el programa, como la base de datos no existe la creará. Lo que veremos será un archivo llamado 'mi_base.db' que estará en el mismo directorio que la aplicación.


A partir de aquí vamos a usar el lenguaje SQL que es un lenguaje que se usa para manejar bases de datos. Más adelante lo veremos en mucho más detalle como funciona pero ahora mismo lo que pretendemos es ver una visión general de como usar sqlite con python.


3. Crear una tabla: Podemos ejecutar comandos SQL para crear tablas en la base de datos.

Podemos ejecutar instrucciones SQL directamente utilizando el objeto 'conexion' sin necesidad de usar un cursor ('c' en el ejemplo siguiente). Cuando ejecutamos instrucciones SQL a través del objeto de conexión, SQLITE automáticamente crea un cursor en segundo plano para ejecutar la consulta. Sin embargo es una buena práctica crear un cursos explícitamente para tener un mayor control sobre las operaciones y para manejar múltiples consultas en una transacción.


try:
    c.execute('''CREATE TABLE libros (
        id INTEGER PRIMARY KEY AUTOINCREMENT NOT NULL,
        título TEXT,
        año INTEGER,
        precio FLOAT,
        descripción TEXT);''')
    print("Tabla de libros creada con éxito")
    
except sqlite3.OperationalError as error:
    print(error)


Antes de seguir vamos a comentar brevemente que es un campo 'Primary Key'. Se trata de un elemento que sirve para identificar cada registro. Tienen una seria de características:

- Ningún registro puede tener la misma 'Primary Key' o clave primaria.

- La 'Primary Key' nunca se vuelve a reutilizar.

- Una 'Primary Key' no se puede modificar una vez creada.

- Una 'Primary Key' debe tener siempre un valor, no puede ser un valor nulo 'NULL'.

En el ejemplo de arriba creamos un campo llamado id, que será un número entero único para cada registro, en el que si nosotros no lo introducimos, automáticamente el programa lo hará por nosotros y además, esos números los irá incrementando automáticamente.

Visto lo anterior continuamos.

Creamos un try/except ya que la primera vez que se ejecute la instrucción se creará la tabla, pero la segunda nos mostrará un error porque ya está creada. Si no queremos usar el gestor de excepciones también podemos usar esta sentencia:


c.execute('''CREATE TABLE IF NOT EXISTS libros (
       id INTEGER PRIMARY KEY AUTOINCREMENT NOT NULL,
       título TEXT,
       año INTEGER,
       precio FLOAT,
       descripción TEXT);''') 

Nota: Aunque en sqlite3 en Python no es necesario, ya que solo se puede ejecutar una instrucción por cada "execute" normalmente todas las instrucciones SQL terminan con un ; porque en SQL si que se pueden ejecutar varias instrucciones simultáneamente en una instrucción.


Trabajando con Registros (CRUD)


- Crear o Insertar datos: Usamos el comando INSERT para agregar datos a la base de datos.

La forma general sería:

INSERT INTO tabla VALUES (valor_campo1, valor_campo2,...,valor_campo_n);

Lo tenemos que hacer en el mismo orden que estén creados los campos. Además tenemos que introducir tantos valores como campos tengamos. Si no queremos especificar un determinado valor deberemos poner Null en el valor de ese campo.

Si quisiéramos introducir los datos en otro orden distinto al que creamos los campos podemos hacerlos de la siguiente forma:

INSERT INTO tabla(campo_n,...,campo2, campo1) VALUES (valor_campo_n,...,valor_Campo2, valor_campo1);

En nuestro ejemplo el código de Python para agregar un valor a la base de datos sería:

c.execute("INSERT INTO libros VALUES (NULL,'El Final', 1998, 15.50, 'libro de ficción');")

Introducimos los campos en el mismo orden en los que lo creamos en la tabla. He puesto NULL en el id porque al crear la tabla, yo no quiero crear el id y será el programa el que lo introduzca por mi automáticamente.

Otra forma, sobre todo si se quiere pasar listas con datos a través de un bucle 'For' o una sentencia 'executemany', sería:

c.execute("INSERT INTO libros (titulo, año, precio, descripción) VALUES (?,?,?,?)", ('El final', 1998, 15.50, 'libro de ficción'))

Si utilizamos 'executemany' entonces para representar los valores nulos se utiliza None en lugar de Null

# Insertar varios registros.
    
set_data = [
        (None, 'El ocho', 1987, 23.50, 'libro de ficción'),
        (None, 'Historia del Arte', 2023, 60, 'libro didáctico'),
        (None,'Programar en Python', 2010, 25, 'libro de Informática'),
        ]

c.executemany("INSERT INTO libros VALUES (?,?,?,?,?);", set_data)


- Recuperar datos: Podemos ejecutar consultas SELECT para recuperar información de la base de datos.

# Recuperar todos los datos
c.execute("SELECT * FROM libros;")
for fila in c:
    print(fila)

La salida sería:

(1, 'El Final', 1998, 15.5, 'libro de ficción')

(2, 'El ocho', 1987, 23.5, 'libro de ficcion')

(3, 'Historia del Arte', 2023, 60.0, 'libro didáctico')

(4, 'Programar en Python', 2010, 25.0, 'libro de Informática')

Podemos tambien utilizar los métodos del cursor: fetchall(), fetchmany(número) y fetchone() para recuperar todos, algunos o uno solo de los registros. Por ejemplo para recuperar todos los registros sería:

# Recuperar todos los datos
c.execute("SELECT * FROM libros;")
datos = c.fetchall()
print(datos)

SALIDA:
[(1, 'El Final', 1998, 15.5, 'libro de ficción'), 
(2, 'El ocho', 1987, 23.5, 'libro de ficción'), 
(3, 'Historia del Arte', 2023, 60.0, 'libro didáctico'), 
(4, 'Programar en Python', 2010, 25.0, 'libro de Informática')]


- Actualizar un Registro. Para actualizar un registro ya existente en la base de datos usamos el comando UPDATE.

# Actualizar un registro
UPDATE tabla SET campo=valor, campo=valor WHERE campo_id=n

En el ejemplo de la librería.

# Actualizar un registro
c.execute("UPDATE libros SET título='otro libro', precio=18 WHERE id=2";)


- Borrar un Registro.  La instrucción DELETE se usa para borrar un registro de una tabla.

# Borrar un registro
DELETE FROM nombre_tabla WHERE condición; 

NOTA IMPORTANTE: ¡Mucho cuidado cuando borres registros en una tabla!. Ten en cuenta la clausula WHERE en la instrucción DELETE. La clausula WHERE especifica que registro debe ser borrado. SI la omites, todos los registros de la tabla se borrarán.

Vamos ahora a borrar el último registro:

# borrar un registro
c.execute("DELETE FROM libros WHERE id=4") 

Si lo que queremos es borrar la tabla y no solo los registros, por ejemplo para empezar de nuevo usaremos la instrucción:

# borrar una tabla
c.execute("DROP TABLE nombre_tabla") 


Después de ver las operaciones básicas CRUD, vamos a ver dos cosas más.

Modificar una tabla para añadir un nuevo campo.

Usamos la instrucción:

# Añadir un nuevo campo a la tabla
ALTER TABLE nombre_tabla ADD nuevo_campo tipo_de_dato;

Por ejemplo si queremos añadir un nuevo campo para poner nuestra opinión sobre los libros (un campo booleano con 0 si no nos ha gustado y 1 si nos ha gustado) haríamos los siguiente:

# Añadir un nuevo campo a la tabla
c.execute("ALTER TABLE libros ADD opinion BOOLEAN")

Todos los registros que ya estuvieran creados de antes aparecerán con el valor NULL para esta columna.


Crear una nueva tabla en la base de datos. (suponemos que ya hay una creada)


Por ejemplo vamos a poner una tabla llamada autor, que tenga los campos nombre, apellidos y editorial.

# Añadir una nueva tabla
    c.execute('''
        CREATE TABLE IF NOT EXISTS autor(
        id INTEGER PRIMARY KEY AUTOINCREMENT NOT NULL,
        nombre TEXT,
        apellidos TEXT,
        editorial TEXT)
''')

4. Confirmar y cerrar: Si no estamos en un entorno contextual (estamos utilizando el with) después de realizar las operaciones necesarias, confirmamos los cambios y cerramos la conexión.

conexion.commit()
c.close()
conexion.close()

¡IMPORTANTE! Utilizar el contexto with en combinación con sqlite3.connect es una excelente práctica para manejar la conexión a la base de datos de manera más segura y eficiente. El bloque with se encargará de cerrar automáticamente la conexión y el puntero una vez que el bloque se haya ejecutado, independientemente de si hay excepciones o no.

Con esta estructura, la conexión se cerrará automáticamente al finalizar el bloque 'with', y no necesitas llamar a conexion.commit() explícitamente, ya que SQLite realizará las confirmaciones automáticamente cuando se cierre la conexión. Esta es una forma segura y práctica de trabajar con bases de datos en Python.

Aquí tienes cómo se vería el código utilizando el contexto with:

import sqlite3

# Creamos la conexión

with sqlite3.connect('mi_base.db') as conexion:

    # Creamos el cursor

    c = conexion.cursor()

    c.execute('''CREATE TABLE IF NOT EXISTS libros (
            id INTEGER PRIMARY KEY AUTOINCREMENT NOT NULL,
            título TEXT,
            año INTEGER,
            precio FLOAT,
            descripción TEXT);''')
        
    # Insertar un registro
    
    c.execute("INSERT INTO libros VALUES (NULL,'El Final', 1998, 15.50, 'libro de ficción');")
    
    # Insertar varios registros.
    
    set_data = [
        (None, 'El ocho', 1987, 23.50, 'libro de ficcion'),
        (None, 'Historia del Arte', 2023, 60, 'libro didáctico'),
        (None,'Programar en Python', 2010, 25, 'libro de Informática'),
        ]
    
    c.executemany("INSERT INTO libros VALUES (?,?,?,?,?);", set_data)

    # Recuperar todos los datos
    
    c.execute("SELECT * FROM libros;")
    datos = c.fetchall()
    print(datos)
    
    # Actualizar un registro.
    c.execute("UPDATE libros SET título='El ocho', precio=18 WHERE id=49")
    
    # Borrar un registro
    c.execute("DELETE FROM libros WHERE id=4")    
    
    # Añadir un nuevo campo a la tabla
    c.execute("ALTER TABLE libros ADD opinion BOOLEAN")
    
    # Añadir una nueva tabla
    c.execute('''
        CREATE TABLE IF NOT EXISTS autor(
        id INTEGER PRIMARY KEY AUTOINCREMENT NOT NULL,
        nombre TEXT,
        apellidos TEXT,
        editoria TEXT)
''')


Ahora que hemos visto lo básico vamos a profundizar más en las instrucciones SQL en si. Para trabajar más cómodamente vamos a necesitar un programa para ver las bases de datos creadas.

1.- En local podemos usar DB Browser for sqlite --> https://sqlitebrowser.org/

2.- Si preferimos trabajar online podemos ir a https://sqliteonline.com/

3.- Para diseñar las bases de datos de forma gráfica podemos utlizar https://drawsql.app/

Los elementos fundamentales de una base de datos son:

Tabla: Una tabla es una estructura de datos fundamental en una base de datos relacional como SQLite. Representa una colección organizada de datos relacionados. Puedes pensar en una tabla como una hoja de cálculo en la que los datos se almacenan en filas y columnas. Cada tabla tiene un nombre único y define la estructura de los datos que contendrá, incluyendo el nombre y el tipo de cada columna.

Columna: Una columna es una parte de una tabla que define el tipo de datos que se almacenan en ella. Cada columna tiene un nombre único y un tipo de datos asociado que especifica el tipo de valores que puede contener. Por ejemplo, una columna podría almacenar números enteros, cadenas de texto, fechas, etc. Las columnas permiten organizar y categorizar los datos en la tabla.

Fila: Una fila, a veces llamada registro o tupla, es una entrada individual en una tabla. Representa un conjunto completo de datos que pertenecen a un único elemento o entidad en el mundo real. Cada fila contiene valores para cada una de las columnas definidas en la tabla. En otras palabras, una fila es una instancia específica de los datos que se almacenan en la tabla.


SQLite admite varios tipos de datos que puedes utilizar en una base de datos en Python. Aquí tienes una lista de los tipos de datos más comunes que puedes emplear en SQLite.


TIPOS DE DATOS.


INTEGER vs. INT: Almacena números enteros. Puedes especificar la longitud, por ejemplo, INTEGER(4) o INT(4) para un entero de 4 bytes. 

REAL vs FLOAT: Almacena números de punto flotante, como números decimales. (FLOAT)

TEXT vs VARCHAR:  En SQLite, puedes utilizar TEXT para almacenar cadenas de texto. La diferencia principal entre TEXT y VARCHAR es que VARCHAR permite especificar una longitud máxima para la cadena, mientras que TEXT no impone una restricción de longitud. Sin embargo, en SQLite, incluso si declaras una columna como VARCHAR, SQLite tratará la columna de manera similar a TEXT, ya que no impone restricciones de longitud máxima de manera estricta. La mayoría de las bases de datos SQLite tratan VARCHAR y TEXT de manera intercambiable. 

BLOB: Almacena datos binarios, como imágenes o archivos.

NUMERIC: Puede almacenar cualquier valor numérico, incluidos enteros y decimales. SQLite intentará convertir automáticamente los valores en el formato adecuado.

BOOLEAN: Aunque SQLite no tiene un tipo BOOLEAN específico, generalmente se usa INTEGER o NUMERIC con valores 0 y 1 para representar valores booleanos (falso y verdadero).

DATE: Puedes almacenar fechas en formato 'YYYY-MM-DD'.

TIME: Para almacenar horas en formato 'HH:MM:SS'.

DATETIME: Combina fecha y hora en un solo campo, en formato 'YYYY-MM-DD HH:MM:SS'.

TIMESTAMP: Se utiliza para almacenar la marca de tiempo (timestamp) de cuándo se insertó o actualizó un registro en una tabla.

Como ejemplo vamos a utilizar esta base de datos que recrea algunos datos de los mundiales de futbol en la que se han definido las siguientes tablas:

- teams: representa las diferentes selecciones que han participado.
- countries: los distintos paises que existen y que están representados por su selección.
- events: los diferentes mundiales que se han disputado.
- events_teams: los mundiales en los que ha participado cada equipo.
- games: Partidos, que equipos jugaron y el resultado.


Aunque ahora no lo entiendas muy bien el esquema de esta base de datos es el siguiente:

diagrama de la base de datos


Seria conveniente que vieras el archivo sql1.py que es que he utilizado para crear la base de datos. En el se ve como conectar a la base de datos, la creación de las tablas y la inserción de datos de diferentes formas.  En el archivo sql2.py encontrarás diversas búsquedas hechas sobre esa base de datos.

A la hora de crear las tablas se pueden especificar ciertas restricciones a los campos y algunas reglas. 

Siempre cada registro de una tabla tiene que tener un identificador único o id al que se denomina, como ya hemos comentado antes, PRIMARY KEY

Por ejemplo en la tabla countries, que recoge algunos países que han participado en un mundial, la instrucción SQL para SQLITE3 de Python que la crea es la siguiente:

sql1.py: creación de la base de datos. primary_key

 c.execute('''
            CREATE TABLE IF NOT EXISTS countries (
            id INTEGER PRIMARY KEY AUTOINCREMENT NOT Null,
            name VARCHAR(255) NOT Null            
            )''')

Como vemos hemos creado dos campos, el campo "id" y el campo "name". Le hemos especificado a la base de datos que el campo id será un número entero que será el "primary_key" de cada registro. Si nosotros no lo especificamos se creará automáticamente, no podrá ser un valor nulo y al ser un primary_key será único y no se podrá repetir. 

También puede ocurrir que un campo de una tabla, haga referencia a otro campo de otra tabla, es lo que se conoce como foreign_key. Por ejemplo en la tabla "games" los campos team1_id y team2_id hacen referencia a registros que están en la tabla "teams" y events_id hace referencia al id del mundial en el que se jugo ese partido y en el que participaron esos equipos y esta en la tabla "events".

sql1.py: creación de la base de datos. foreign_key

c.execute('''
            CREATE TABLE IF NOT EXISTS games (
            id INTEGER PRIMARY KEY AUTOINCREMENT NOT Null,
            event_id INTEGER NOT Null,
            round VARCHAR(255) NOT NULL,
            team1_id INTEGER NOT Null,
            team2_id INTEGER NOT Null,
            play_at DATETIME NOT Null,
            score1 INTEGER,
            score2 INTEGER,
            winner INTEGER,
            FOREIGN KEY(event_id) REFERENCES events(id),
            FOREIGN KEY(team1_id) REFERENCES teams(id),
            FOREIGN KEY(team2_id) REFERENCES teams(id))''')

Las claves externas o FOREIGN KEY se añaden al final de la instrucción una vez definidos los campos.

    ELEMENTOS DEL LENGUAJE SQL.


- Mostrar un elemento.


La estructura de la instrucción SQL para mostrar un elemento es:

   SELECT campo FROM tabla;
Nos mostrará el campo seleccionado de la tabla que le hayamos indicado. 
Si sustituimos campo por * un asterisco nos mostrará todos los campos de esa tabla.

En la base de datos de ejemplo si queremos mostrar el "title", el nombre de los países, de la tabla "teams" equipos:

consulta a la base de datos


Si queremos mostrar todos los campos de esa tabla utilizamos el wildcard *.

mostrar todos los campos de la tabla


Podemos usar también una serie de condicionantes para el registro.

Por ejemplo para que nos muestra en esta tabla "teams" que registro o registros tienen un valor del campo "title" igual a Spain.

   SELECT * FROM teams WHERE title='Spain';

clausula WHERE

Como el id de Spain en la tabla "teams" es 129 podemos contar las veces que en esta base de datos España ha jugado un partido en el mundial. 

 SELECT count(*) FROM games WHERE team1_id=129 or team2_id=129;
clausula COUNT(*)

En este caso han sido en 11 ocasiones, es decir hay 11 registro en el que se cumple la condición que hemos especificado. 

COUNT(*) -> devuelve el número de registros que cumplen la condición.

Podemos ordenar la forma en la que se muestran los registros con la clausula ORDER BY. Por ejemplo en la tabla "teams" se nos muestren los registros ordenados por "title".

SELECT id, title FROM teams ORDER BY title;
clausula ORDER BY


Lo mismo pero en orden descendente:

SELECT id, title FROM teams ORDER BY title DESC;
clausula ORDER BY DESC


También en vez del nombre del campo o columna se puede poner un número que será el que le corresponda según la posición que ocupe en la tabla. Lo mismo que antes se puede conseguir con esta instrucción:

SELECT id, title FROM teams ORDER BY 3 DESC;
donde 3 es el orden del campo "title" en la tabla "teams".

Operadores que se pueden utilizar con la clausula WHERE.


=igual
>mayor que
>= mayor o igual que
!>no más grande que
<menos que
<=menor o igual que
!<no menor que
<>no igual que
!= no igual que
BETWEENentre los valores especificados incluidos los mismos
IS NULLsi es un missing value

Un ejemplo podría ser:

SELECT campo, campo, campo FROM tabla WHERE campo<>1;


Filtros Avanzados AND, OR o IN.


Se pueden anidar sentencias usando el operador AND como en los siguientes ejemplos. (AND = y )

SELECT campo, campo, campo FROM tabla WHERE campo>2 AND campo>3;
Que se cumpla una condición u otra con OR:

SELECT campo, campo, campo FROM tabla WHERE campo>2 OR campo>3;
Se pueden utilizar paréntesis para agrupar opciones:

SELECT campo, campo, campo FROM tabla WHERE (campo=1 OR campo=2) AND campo>=2;
La clausula "IN" en SQL se utiliza para filtrar filas en una consulta en función de una lista de valores especificados. Básicamente, nos permite seleccionar filas cuyos valores en una columna coincidan con uno o más valores en una lista. Es útil cuando queremos recuperar registros que cumplan con múltiples condiciones en una sola consulta .

SELECT columnas FROM tabla WHERE columna IN (valor1, valor2, valor3...);

WILD CARDS.


Las "WILD CARDS" o comodines en SQL son caracteres especiales que se utilizan en las consultas para buscar patrones de texto en una columna de una tabla. Los comodines más comunes en SQL son el asterisco '*', el signo de '%' y el guion bajo '_'.

1.- Asterisco '*' El asterisco se utiliza para seleccionar todas las columnas de una tabla en una consulta. Esto ya lo hemos visto anteriormente en múltiples casos:

 SELECT * FROM teams WHERE title='Spain';

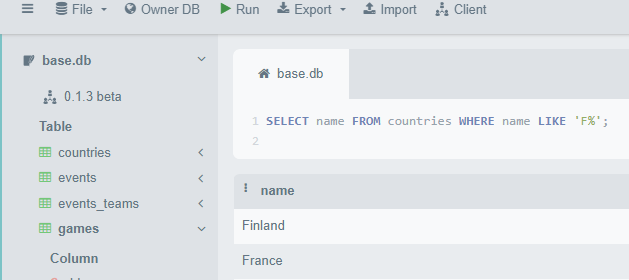
2.- Porcentaje '%': El signo de porcentaje se usa como comodín en combinación con la clausula 'LIKE' para buscar patrones de texto en una columna. Por ejemplo:


SELECT name FROM countries WHERE name LIKE 'F%';

uso wild card %


Nos devuelve el nombre de todos los países de la tabla 'countries' que empiecen por la letra 'F'

O por ejemplo:

'%texto': encuentra los registros que termine con texto.
'texto%': encuentra los registros que comiencen con texto.
'%texto%': encuentra los registros que contengan la palabra 'texto' en cualquier parte.

3.- Guiones Bajos (_): El guion bajo _ se utiliza como comodín junto con la clausula LIKE para buscar patrones de texto, pero en lugar de representar múltiples caracteres, representa un único carácter. Por ejemplo:

SELECT name FROM countries WHERE name LIKE '_o%';
wild card guión bajo

Esta consulta selecciona todos los nombres de países donde el segundo carácter es una 'o' y dando igual el texto que haya después.

Foreign Keys.


FOREIGN KEY(nombre_campo) REFERENCES nombre_tabla(nombre_campo)
Se definen al final de la instrucción SQL que crea esa tabla.

Cada tabla debería tener una Primary Key que es única para cada registro de la tabla. Las Foreigns Keys son como las bases de datos, representan las relaciones entre las tablas. Mientras que una tabla solo tiene una Primary Key, puede tener múltiples Foreign Keys, una por cada tabla con la que tenga relación.

Tipos de relaciones.

One to Many. Un registro en una tabla puede relacionarse con uno o más registros en otra tabla. Esto se puede implementar utilizando una clave foránea en la tabla "many" que hace referencia a la clave principal en la tabla "one". El ejemplo tipico es que un autor puede haber escrito varios libros pero un libro solo puede tener un autor.

import sqlite3

# Conectarse a la base de datos SQLite
conn = sqlite3.connect('biblioteca.db')
cursor = conn.cursor()

# Crear la tabla de Autores
cursor.execute('''CREATE TABLE autores (
                    id INTEGER PRIMARY KEY,
                    nombre TEXT)''')

# Crear la tabla de Libros
cursor.execute('''CREATE TABLE libros (
                    id INTEGER PRIMARY KEY,
                    titulo TEXT,
                    autor_id INTEGER,
                    FOREIGN KEY (autor_id) REFERENCES autores(id))''')

# Insertar datos
cursor.execute("INSERT INTO autores (nombre) VALUES ('J.K. Rowling')")
cursor.execute("INSERT INTO libros (titulo, autor_id) VALUES ('Harry Potter y la piedra filosofal', 1)")
cursor.execute("INSERT INTO libros (titulo, autor_id) VALUES ('Harry Potter y la cámara secreta', 1)")

# Consulta para obtener todos los libros de un autor específico (por ejemplo, J.K. Rowling)
cursor.execute("SELECT libros.titulo FROM libros JOIN autores ON libros.autor_id = autores.id WHERE autores.nombre = 'J.K. Rowling'")
libros_jk_rowling = cursor.fetchall()
print("Libros de J.K. Rowling:")
for libro in libros_jk_rowling:
    print(libro[0])

# Cerrar la conexión
conn.commit()
conn.close()


One to one. Un registro en una tabla solo puede estar relacionado con un registro en otra. Esto se consigue generalmente mediante la inclusión de una clave foránea en una de las tablas. En el ejemplo del futbol un país solo puede tener un equipo que lo represente un equipo nacional puede pertenecer a un solo paí.


# tabla countries
c.execute('''
            CREATE TABLE IF NOT EXISTS countries (
            id INTEGER PRIMARY KEY AUTOINCREMENT NOT Null,
            name VARCHAR(255) NOT Null            
            )''')

# tabla teams
c.execute('''
            CREATE TABLE IF NOT EXISTS teams (
            id INTEGER PRIMARY KEY AUTOINCREMENT NOT Null,
            key VARCHAR(255) NOT Null,
            title VARCHAR(255) NOT Null,
            country_id INTEGER NOT Null,
            FOREIGN KEY(country_id) REFERENCES countries (id))''')
Otro ejemplo aquí.

Many to many. Uno o más registros pueden relacionarse con uno o mas registros en otra tabla.
Esto se logra creando una tabla intermedia que conecta las dos tablas. En nuestro ejemplo del futbol un equipo (teams) puede participar en varios mundiales (events) y en un mundial pueden participar varios equipos.

many to many relation

# tabla events
c.execute('''
            CREATE TABLE IF NOT EXISTS events (
            id INTEGER PRIMARY KEY AUTOINCREMENT NOT Null,
            key VARCHAR(255) NOT Null,
            start_at DATE NOT Null,
            end_at DATE)''')

# tabla temas
c.execute('''
            CREATE TABLE IF NOT EXISTS teams (
            id INTEGER PRIMARY KEY AUTOINCREMENT NOT Null,
            key VARCHAR(255) NOT Null,
            title VARCHAR(255) NOT Null,
            country_id INTEGER NOT Null,
            FOREIGN KEY(country_id) REFERENCES countries (id))''')

# tabla many to many events_teams
c.execute('''
            CREATE TABLE IF NOT EXISTS events_teams (
            id INTEGER PRIMARY KEY AUTOINCREMENT NOT Null,
            event_id INTEGER NOT Null,
            team_id INTEGER NOT Null,
            FOREIGN KEY(event_id) REFERENCES events (id),
            FOREIGN KEY(team_id) REFERENCES teams (id))''')
Otro ejemplo aquí.

Seleccionando datos en múltiples tablas.


Una vez que hemos visto como se relacionan las tablas en una base de datos, vamos a ver como combinar datos de dos o más tablas en función de una columna común.

Supongamos que tienes dos tablas en tu base de datos: "clientes" y "pedidos", y ambas tienen una columna llamada "cliente_id" que se utiliza para relacionar los registros. Vamos a crear las tablas y poner algunos datos.

import sqlite3

# Conectarse a la base de datos o crearla si no existe
conn = sqlite3.connect("mi_base_de_datos.db")
cursor = conn.cursor()

# Crear la tabla "clientes"
cursor.execute("""
    CREATE TABLE IF NOT EXISTS clientes (
        cliente_id INTEGER PRIMARY KEY,
        nombre TEXT,
        email TEXT
    );
""")

# Crear la tabla "pedidos"
cursor.execute("""
    CREATE TABLE IF NOT EXISTS pedidos (
        pedido_id INTEGER PRIMARY KEY,
        cliente_id INTEGER,
        producto TEXT,
        cantidad INTEGER,
        FOREIGN KEY (cliente_id) REFERENCES clientes (cliente_id)
    );
""")

# Confirmar los cambios y cerrar la conexión
conn.commit()
conn.close()
Ahora vamos a ver como mostrar los nombres de los clientes y los productos de los pedidos que tienen coincidencias en ambas tablas.  Para ello utilizaremos la sentencia INNER JOIN que devuelve solo los registros que tienen coincidencias en ambas tablas.

Ejemplo de INNER JOIN.

import sqlite3

# Conectarse a la base de datos
conn = sqlite3.connect("mi_base_de_datos.db")
cursor = conn.cursor()

# Consulta SQL utilizando INNER JOIN
query = """
SELECT clientes.nombre, pedidos.producto
FROM clientes
INNER JOIN pedidos ON clientes.cliente_id = pedidos.cliente_id;
"""

# Ejecutar la consulta y obtener resultados
cursor.execute(query)
resultados = cursor.fetchall()

# Imprimir resultados
for resultado in resultados:
    print(resultado)

# Cerrar la conexión
conn.close()
El resultado sería algo como esto:

antonio	| alicates
antonio	| tenazas
ana	| llave inglesa
Vamos a ver como funciona:

  • 'SELECT clientes.nombre, pedidos.producto': Esta parte de la consulta especifica las columnas que deseas seleccionar en el resultado. En este caso, estás seleccionando las columnas "nombre" de la tabla "clientes" y "producto" de la tabla "pedidos".

  • 'FROM clientes': Aquí se indica la tabla principal de la que deseas seleccionar datos. En este caso, estás seleccionando datos de la tabla "clientes".

  • 'INNER JOIN pedidos ON clientes.cliente_id = pedidos.cliente_id': Esta es la parte clave de la consulta que realiza la combinación entre las dos tablas. Aquí se está utilizando INNER JOIN para combinar registros de las tablas "clientes" y "pedidos" en función de una condición. La condición de unión es clientes.cliente_id = pedidos.cliente_id, lo que significa que los registros se combinarán cuando el valor de la columna "cliente_id" en la tabla "clientes" sea igual al valor de la columna "cliente_id" en la tabla "pedidos".

Cuando se ejecuta esta consulta, obtendrás un conjunto de resultados que incluirá el nombre de los clientes y los productos de los pedidos que coinciden en la columna "cliente_id". En otras palabras, esta consulta te dará una lista de clientes y los productos que han pedido.

Esencialmente, INNER JOIN se utiliza para seleccionar datos de dos o más tablas relacionadas únicamente cuando hay coincidencias en las columnas especificadas en la condición de unión. Si no hay coincidencias, esos registros no aparecerán en el resultado.


Ejemplo de LEFT JOIN.

Devuelve todos los registros de la tabla1 (clientes) y los registros coincidentes de la tabla2 (pedidos), si los hay. Si no los hay los datos de la tabla2(pedidos) serán NULL. He puesto un cliente nuevo que aun no tiene pedidos y he ejecutado la instrucción.

import sqlite3

# Conectarse a la base de datos
conn = sqlite3.connect("mi_base_de_datos.db")
cursor = conn.cursor()

# Consulta SQL utilizando LEFT JOIN
query = """
SELECT clientes.nombre, pedidos.producto
FROM clientes
LEFT JOIN pedidos ON clientes.cliente_id = pedidos.cliente_id;
"""

# Ejecutar la consulta y obtener resultados
cursor.execute(query)
resultados = cursor.fetchall()

# Imprimir resultados
for resultado in resultados:
    print(resultado)

# Cerrar la conexión
conn.close()
En este caso la salida es:

ana	| llave inglesa
antonio	| alicates
antonio	| tenazas
teresa	| NULL
Existen más instrucciones pero no vamos a entrar de momento en ellas.

OPERACIONES CON BASES DE DATOS.


 - CONTAR el numero de filas o registros.

SELECT count(*) FROM Nombre_Tabla;
Para que la salida no aparezca count(*) sino algo más legible podemos poner un alias usando la clave AS.

SELECT count(*) AS Numero_Registos FROM Nombre_Tabla;
También podemos utilizar la clausula WHERE para filtrar los resultados.

SELECT count(*) AS Numero_Registos FROM Nombre_Tabla WHERE condición;


- SUMAR una columna.

SELECT SUM(columna) AS Valor_Total FROM Nombre_Tabla WHERE condición;

- MEDIA de una Columna. 

SELECT AVG(columna) AS Valor_Total FROM Nombre_Tabla WHERE condición;

- AGRUPAR datos.

Agrupa registros o filas basándose en una determinada columna.

SELECT columna_1, count(*) FROM Nombre_Tabla GROUP BY columna_1;

CHULETA de declaraciones SQL básicas.


Declaración Descripción Código de Ejemplo
SELECT  Recupera datos de una o más tablas basadas en columnas especificadas.  SELECT column1, column2 FROM table_name;
FROM  Especifica la tabla de la que se obtienen los datos recuperados.  SELECT column1, column2 FROM table_name;
WHERE  Filtra los datos según las condiciones especificadas.  SELECT column1, column2 FROM table_name WHERE condition;
ORDER BY  Ordena el conjunto de resultados según la columna especificada en orden ascendente (ASC) o descendente (DESC).  SELECT column1, column2 FROM table_name ORDER BY column1 ASC;
GROUP BY  Agrupa las filas o registros en base a la columna especificada.  SELECT column1, COUNT(*) FROM table_name GROUP BY column1;
HAVING  Filtra datos agrupados según lo especificado en las condiciones.  SELECT column1, COUNT(*) FROM table_name GROUP BY column1 HAVING COUNT(*) > 1;
INSERT INTO  Inserta datos en una tabla.  INSERT INTO table_name (column1, column2) VALUES (value1, value2);
UPDATE  Modifica o actualiza los datos en una tabla en base a lo especificado en las condiciones.  UPDATE table_name SET column1=value1 WHERE condition;
DELETE FROM  Elimina datos de una tabla según lo especificado en las condiciones.  DELETE FROM table_name WHERE condition;
JOIN  Combina filas o registros de varias tablas según tengan columnas relacionadas.  SELECT column1, column2 FROM table1 JOIN table2 ON table1.column = table2.column
INNER JOIN  Devuelve solo las filas coincidentes de ambas tablas.   SELECT column1, column2 FROM table1 INNER JOIN table2 ON table1.column = table2.column;
LEFT JOIN  Devuelve todas las filas de la tabla izquierda o tabla 1 y las coincidentes en la tabla derecha o tabla 2.   SELECT column1, column2 FROM table1 LEFT JOIN table2 ON table1.column = table2.column;
RIGHT JOIN  Devuelve todas las filas de la tabla derecha o tabla 2 y las coincidentes de la tabla derecha o tabla 1.  SELECT column1, column2 FROM table1 RIGHT JOIN table2 ON table1.column = table2.column;
FULL JOIN  Devuelve todas las filas o registros de ambas tablas.  SELECT column1, column2 FROM tabke1 FULL JOIN table2 ON table1.column = table2.column;
DISTINCT  Devuelve los valores únicos de una columna  SELECT DISTINCT column1 FROM table_name;
COUNT  Cuenta el número de filas o valores no nulos en una columna.  SELECT COUNT(*) FROM table_name;
or
 SELECT COUNT(column1) FROM table_name;
SUM  Calcula la suma de valores en una columna.  SELECT SUM(column1) FROM table_name; 
AVG  Calcula el valor promedio de una columna.  SELECT AVG(column1) FROM table_name;
MAX  Encuentra el valor máximo en una columna.  SELECT MAX(column1) FROM table_name;
MIN  Encuentra le valor mínimo en una columna.  SELECT MIN(column1) FROM table_name;


....